Pasado, presente y futuro de la Plataforma interna de Akua
Hoy quiero contarles un poco del pasado, el presente y el futuro que ambicionamos para el IDP en Akua.
Para arrancar voy a traer una frase que escuché en la peli Kung Fu Panda
“El ayer es historia, el mañana es un misterio, el hoy es un regalo, por eso se llama presente”
Por qué la traigo? porque como comenté en la descripción de la publicación pasaron muchas cosas desde aquel junio del 2024 donde con mi entonces compañero, dupla de equipo y puedo decir amigo el loco German Yepes comenzamos a diseñar la plataforma interna de desarrollo para Akua.
En el presente mientras escribo esto comparto equipo con Cristan Ortega (Cris) y Jeremy Bacher (Jere), en un pasado como les comenté formé dupla con el chavito, quien decidió seguir camino fuera de Akua allá por diciembre del 2025, y en el camino también supo estar con nosotros don Guille Pijuan que sigue en Akua haciendo de las suyas en el equipo de CX (Customer Experience).
Hace un tiempo (casi dos años) contamos un poco del IDP; hoy vengo a contarles de un proyecto en particular, Good Bye AWS DMS (Database Migration Service).
Hoy arranca una “Trilogía de BlogPost de la Plataforma”, para arrancar me toca a mí estar acá escribiendo y pronto tendremos a Cris y a Jere contando diferentes desafíos técnicos que nos enorgullece compartirles.
Comencemos.
El ayer es historia: AWS DMS
Antes de meternos en el barro, un poco de contexto de cómo se mueven los datos en Akua: cada proyecto tiene su propia base Aurora PostgreSQL y cada tenant tiene su warehouse, el ODS (Operational Data Store), donde se juntan las bases de todos los proyectos para que quien necesite consultar esos datos lo haga ahí y no contra la base productiva del proyecto.
Para llevar los datos de un lado al otro usábamos AWS DMS Serverless, que en el papel es justo lo que necesitás: hace una carga inicial y después se queda replicando los cambios en tiempo real –aka CDC, Change Data Capture–. En el papel.
En la práctica DMS fallaba, y lo que más nos dolía no era que fallara (todo falla tarde o temprano) sino cómo fallaba: en silencio. Dejo un punteo de lo que encontramos el día que nos pusimos a mirar en serio:
- Replicaciones muertas sin que nadie se entere, 8 replicaciones en estado
faileddurante meses; sin un ruido, nada. - El “running” que no corría, tablas en
Table errormientras la replicación decía estarrunning, osea la consola te decía que todo estaba bárbaro y la tabla hacía rato que no recibía un dato. - Duplicados por doquier, un warehouse con filas duplicadas entre 80 y 100 veces. Sí, leíste bien, de 80 a 100 veces 😅.
- Y encima caro, alrededor de USD 7.400 por mes.
Y por qué puede duplicar? DMS guarda su “hasta dónde repliqué” (el checkpoint) por un lado y escribe los datos por otro; si algo se corta entre una cosa y la otra, al volver puede reaplicar lo que ya había escrito. Guarden este detalle porque es justamente lo que resolvimos distinto.
Si se acuerdan de nuestros mantras de Construir desde las diferencias, el primero dice que la operación y mantenimiento de nuestra plataforma debe tender a cero; con DMS pasaba exactamente lo contrario, había que operarlo hasta para enterarse de que estaba roto.
Así que nos hicimos la pregunta incómoda, y si lo construimos nosotros? Atenti, no es una decisión que se toma a la ligera, todo lo que construís después lo tenés que mantener; pero cuando la herramienta de turno te dice que está todo bien mientras por debajo se está prendiendo fuego, la cuenta empieza a cerrar bastante rápido.
El hoy es un regalo: data-replicator
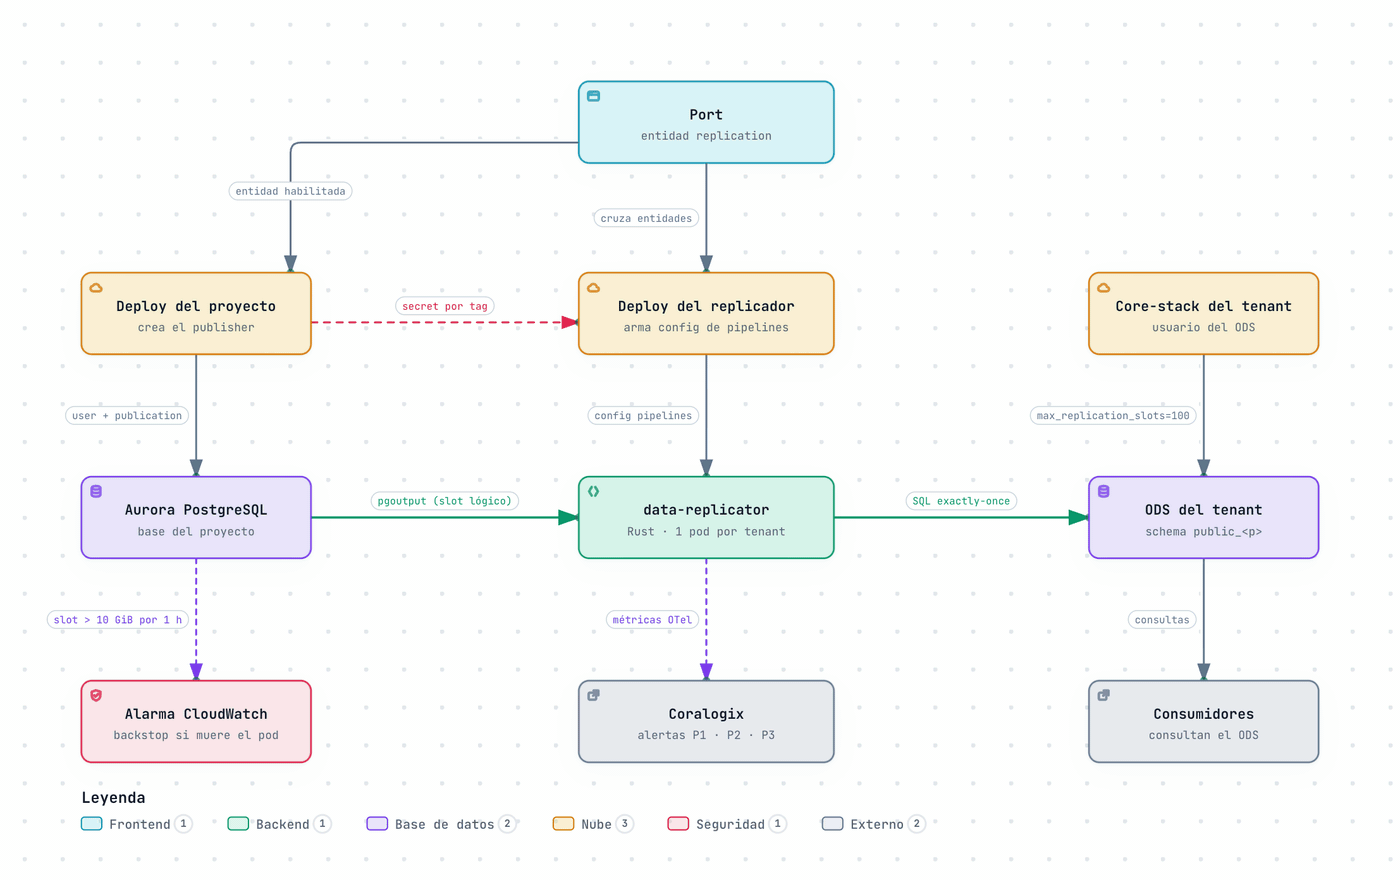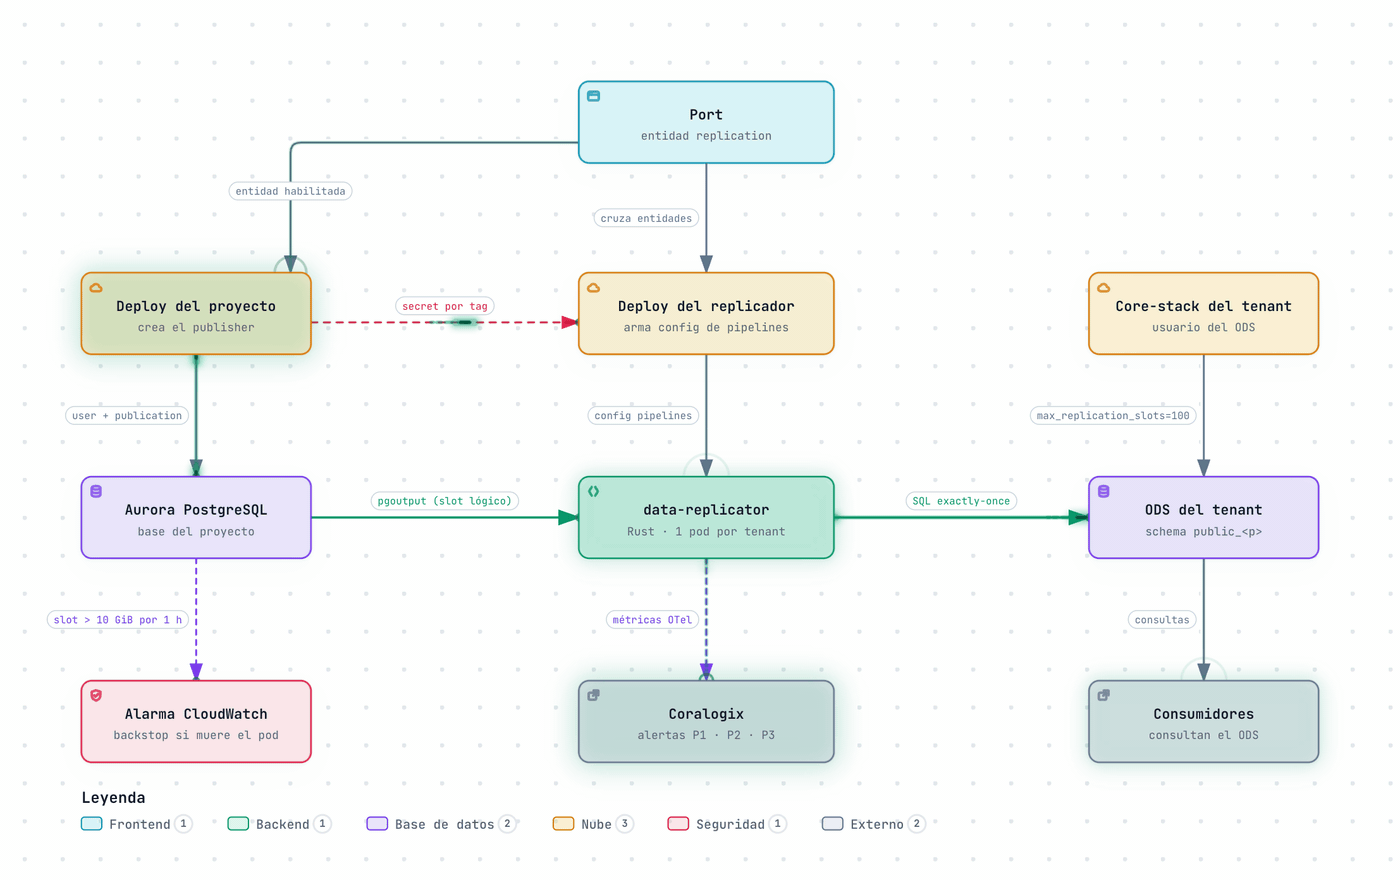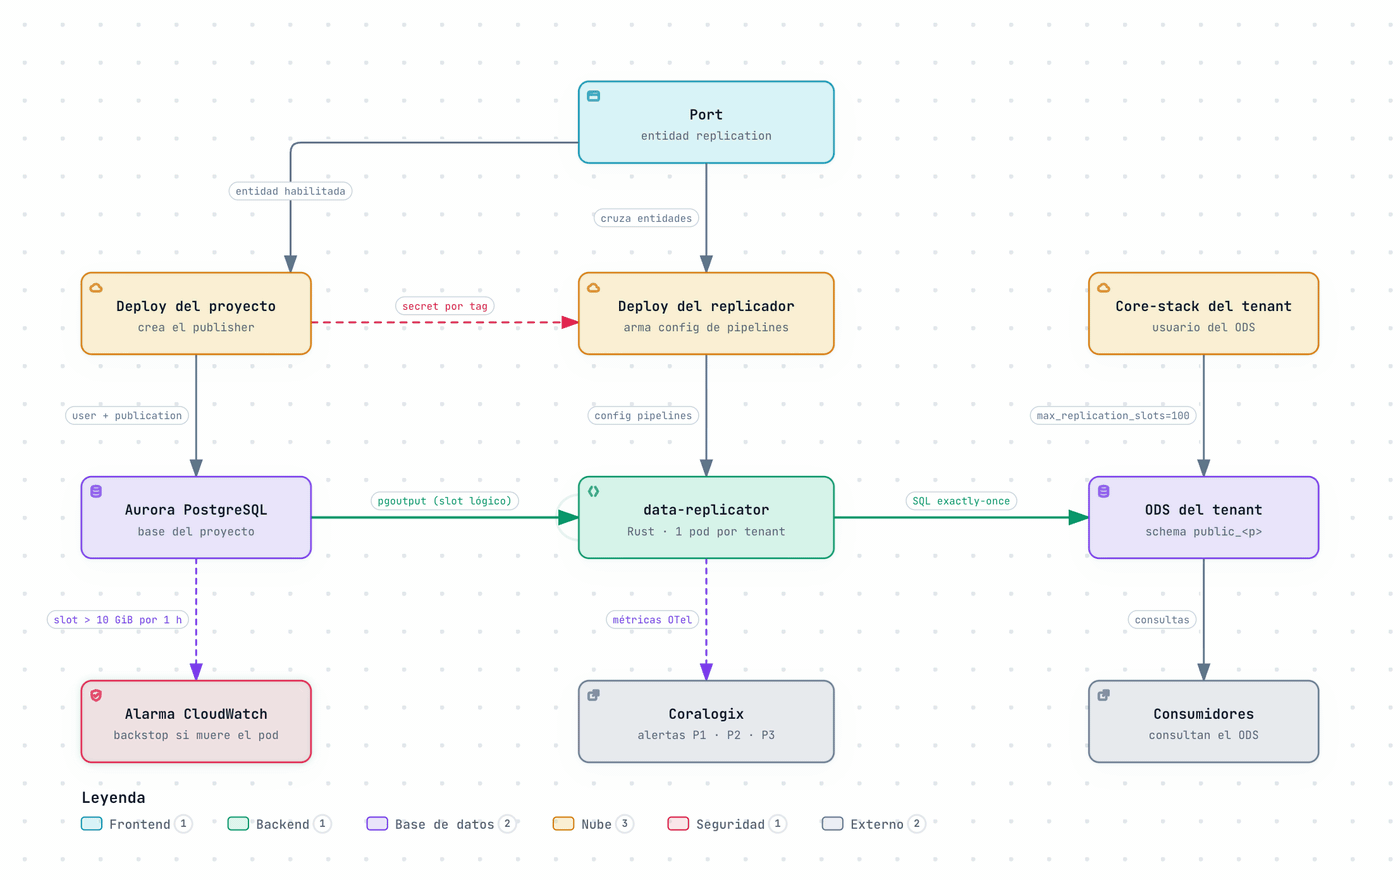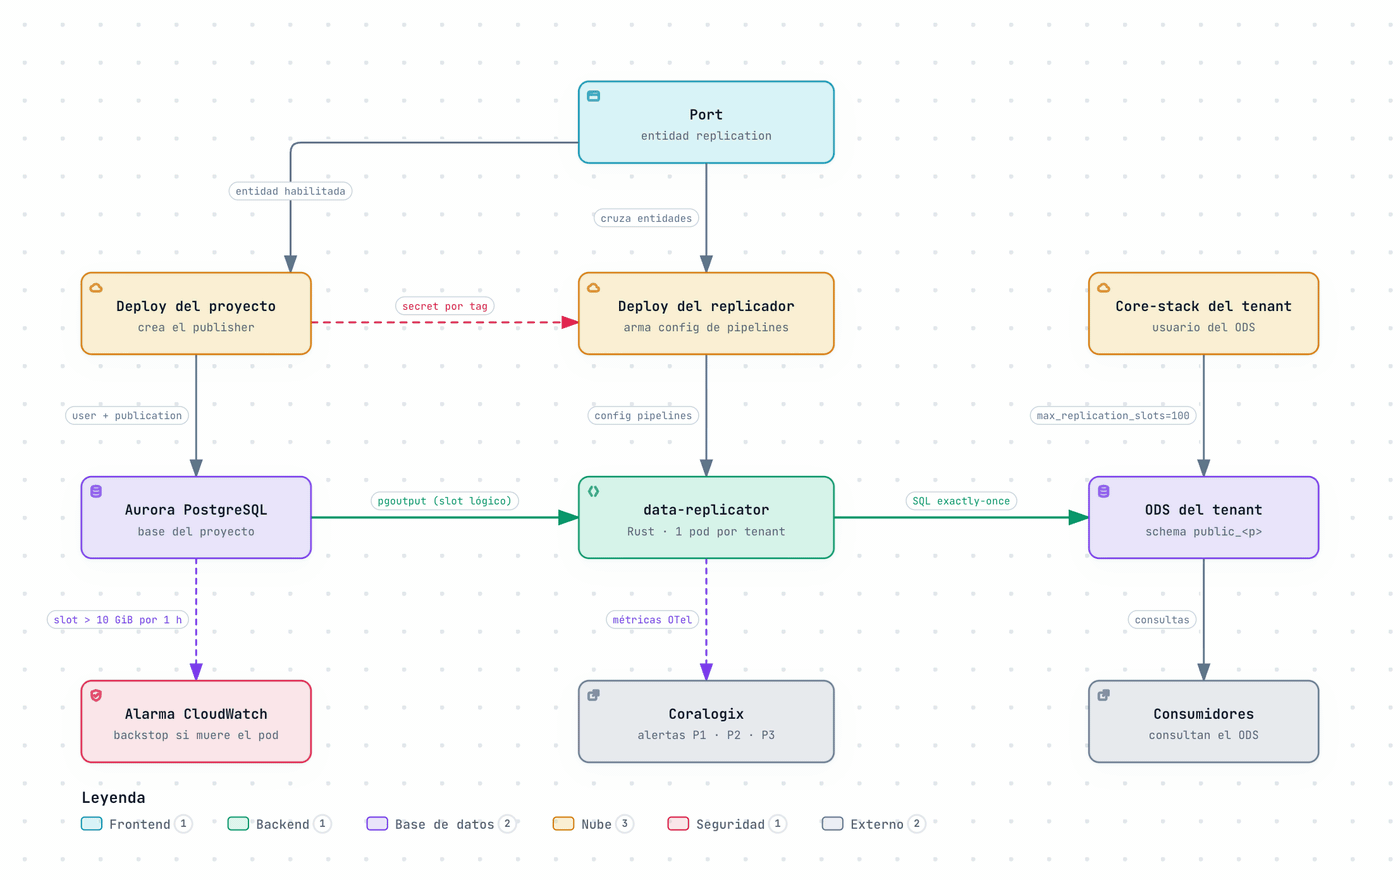
El data-replicator es un proceso escrito en Rust –el porqué de Rust da para su propia publicación– que copia las bases Aurora PostgreSQL de cada proyecto al ODS de su tenant y las mantiene al día en tiempo real.
Aurora del proyecto ──pgoutput (slot lógico)──▶ data-replicator ──SQL──▶ ODS del tenant
   publication                                  1 pod por tenant         schema public_<p>
   usuario dedicado                             1 tarea por pipeline     + origin por pipeline
La arquitectura es simple a propósito (otro de los mantras, la simpleza ante todo): un pod por tenant en Fargate que corre todas los pipelines de ese tenant, donde un pipeline es una base de origen. Ese pod cuesta unos USD 72 por mes. Si un pipeline se rompe las demás ni se enteran, cada uno corre aislado y supervisado por separado.
Así se ve el cuadro completo; de cada pieza hablo en las secciones que siguen:
Un momento, qué es un slot?
Para quien nunca se peleó con la replicación lógica de PostgreSQL, un mini glosario:
- Publication, define qué tablas de la base se publican; en nuestro caso todas (
FOR ALL TABLES). - pgoutput, el plugin nativo de PostgreSQL que lee el WAL y emite las transacciones como mensajes (Begin, Insert, Update, Delete, Commit…).
- Slot, un cursor persistente en el origen que retiene el WAL hasta que el consumidor confirma que lo procesó. Ojo con esto: si nadie lo consume, el disco crece y crece.
- LSN, la posición dentro del WAL; el “por dónde voy”.
La vida de un pipeline
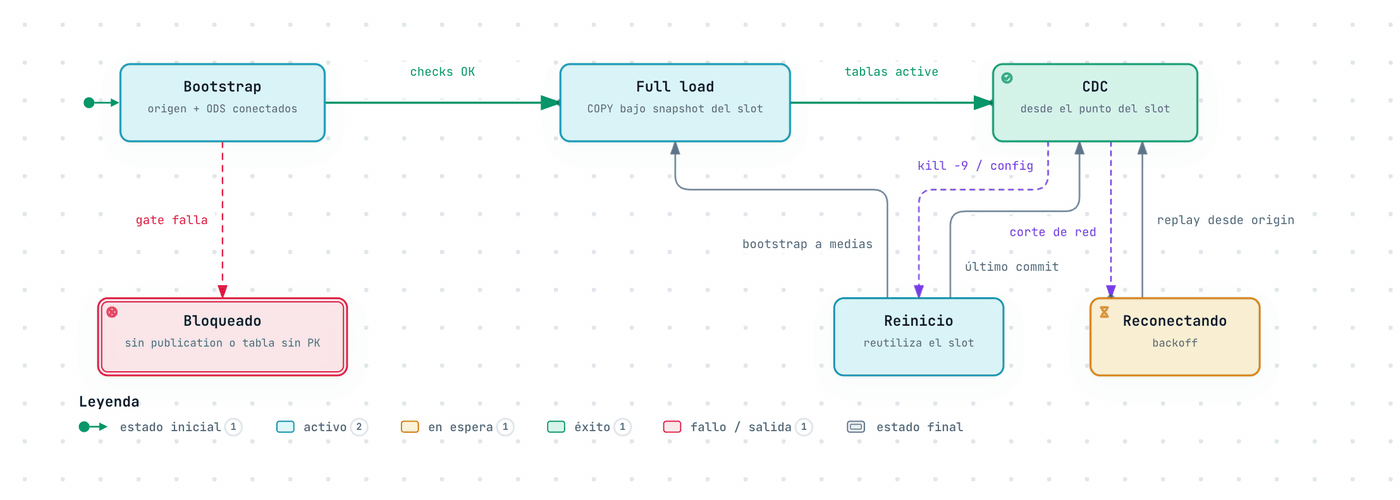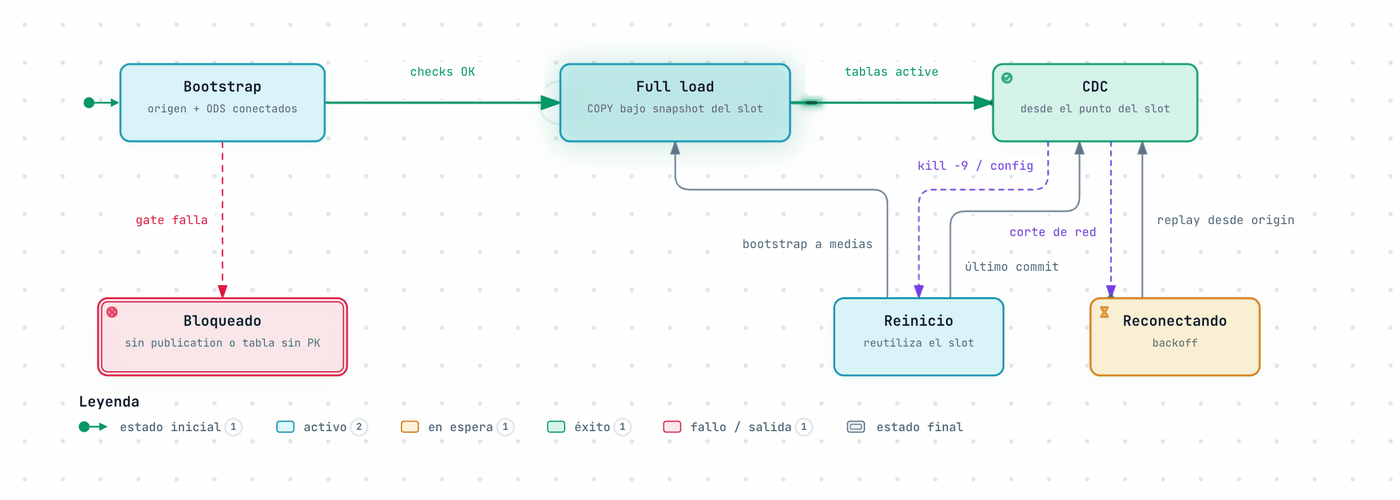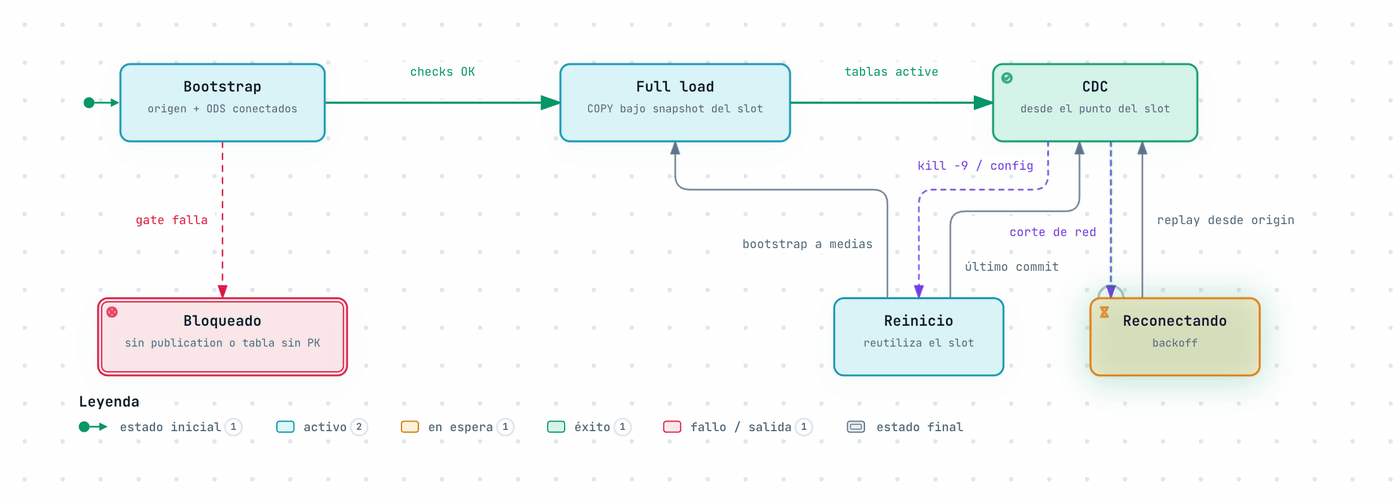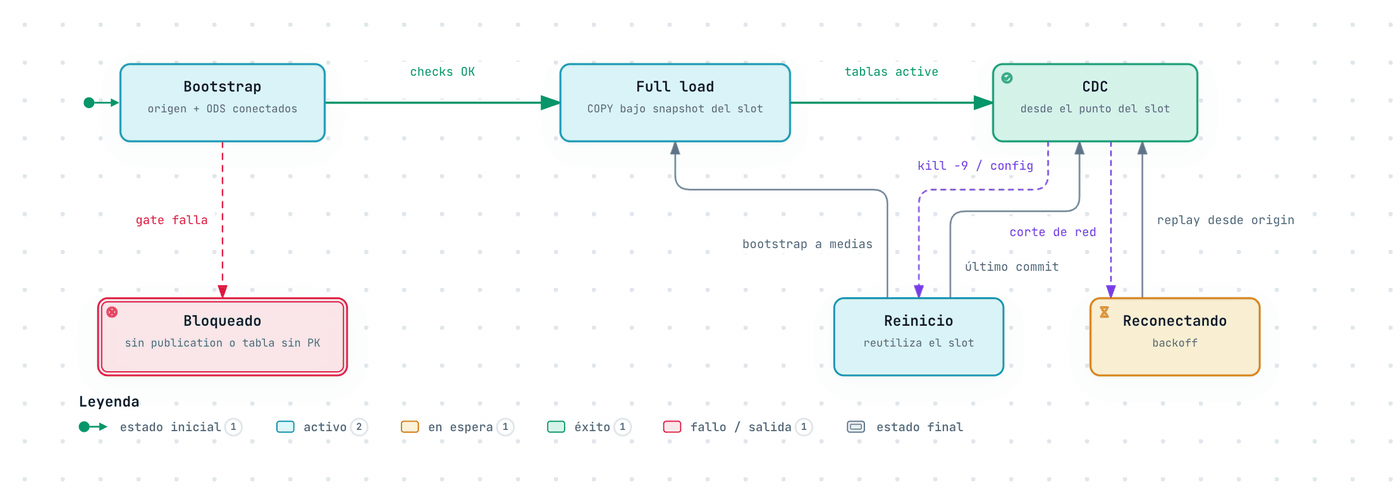
Cada pipeline pasa por cuatro etapas:
- Bootstrap, se conecta al origen con un usuario dedicado y al ODS, verifica que exista la publication –la crea la plataforma en el deploy del proyecto, no el pod– y que ninguna tabla esté sin primary key. Esto último no es un capricho: en PostgreSQL si publicás una tabla sin replica identity los UPDATE y DELETE de la aplicación sobre esa tabla empiezan a fallar, así que el gate está para cuidar al proyecto, no al replicador.
- Full load consistente, crea el slot exportando un snapshot y copia cada tabla bajo ese snapshot con
COPY. Del lado del ODS elTRUNCATE, los datos y la marca de estado van en una única transacción por tabla: o la tabla queda completa yactive, o no queda nada. Nada de tablas a medio cargar. - CDC, arranca exactamente desde el punto consistente del slot, así que entre la carga inicial y los cambios no hay huecos ni duplicados. Cada transacción del origen se aplica como una transacción en el ODS, con statements preparados y pipelineados –se mandan de a 500 sin esperar respuesta–, así una transacción chica cuesta un round-trip y no seis.
- Reinicio, reutiliza el slot existente y retoma desde el último commit aplicado. Sin full load, salvo que el bootstrap haya quedado a medias.
El ciclo completo, desvíos incluidos:
Exactly-once, o la garantía que DMS no da
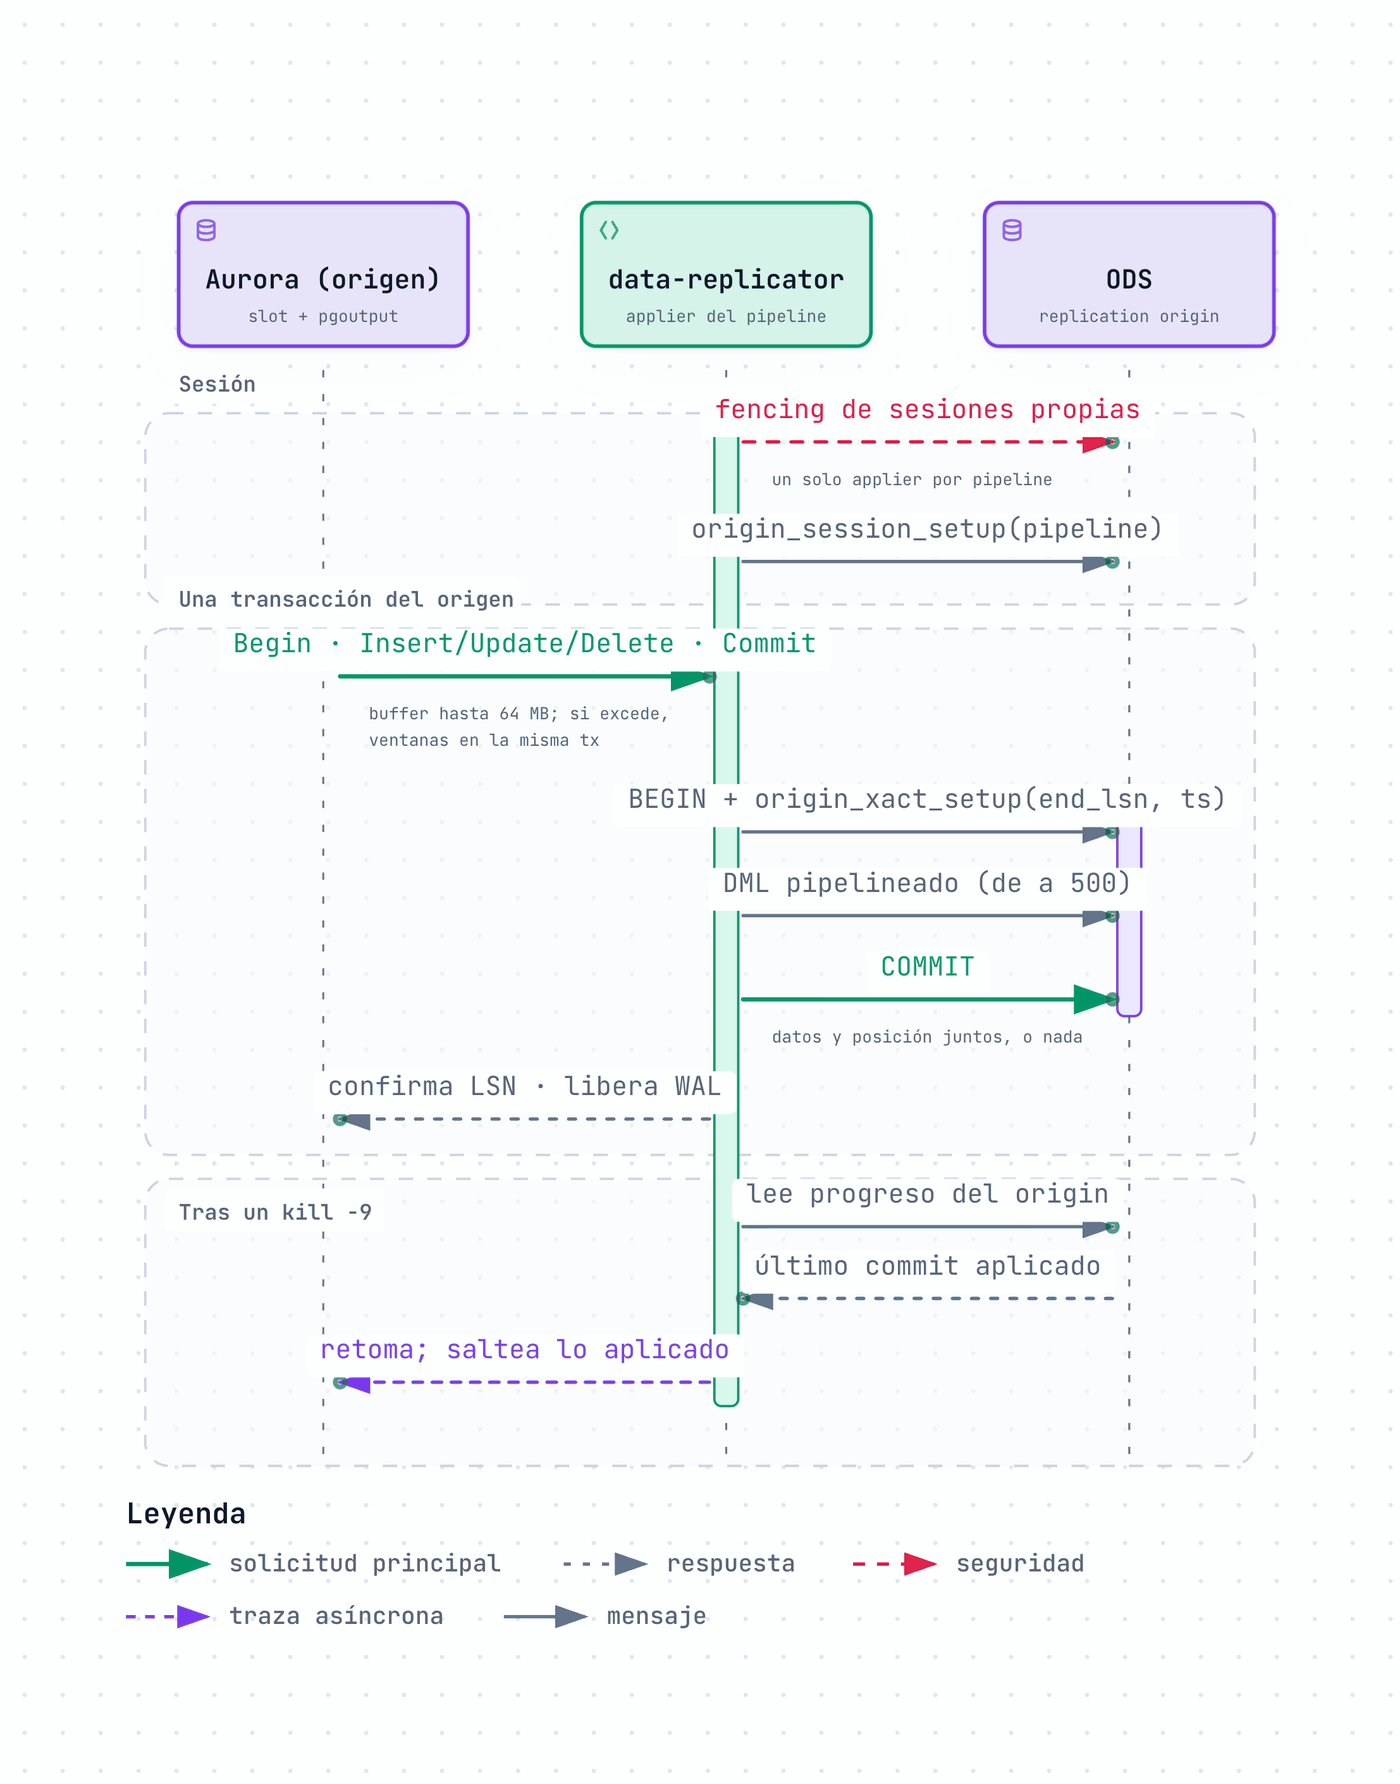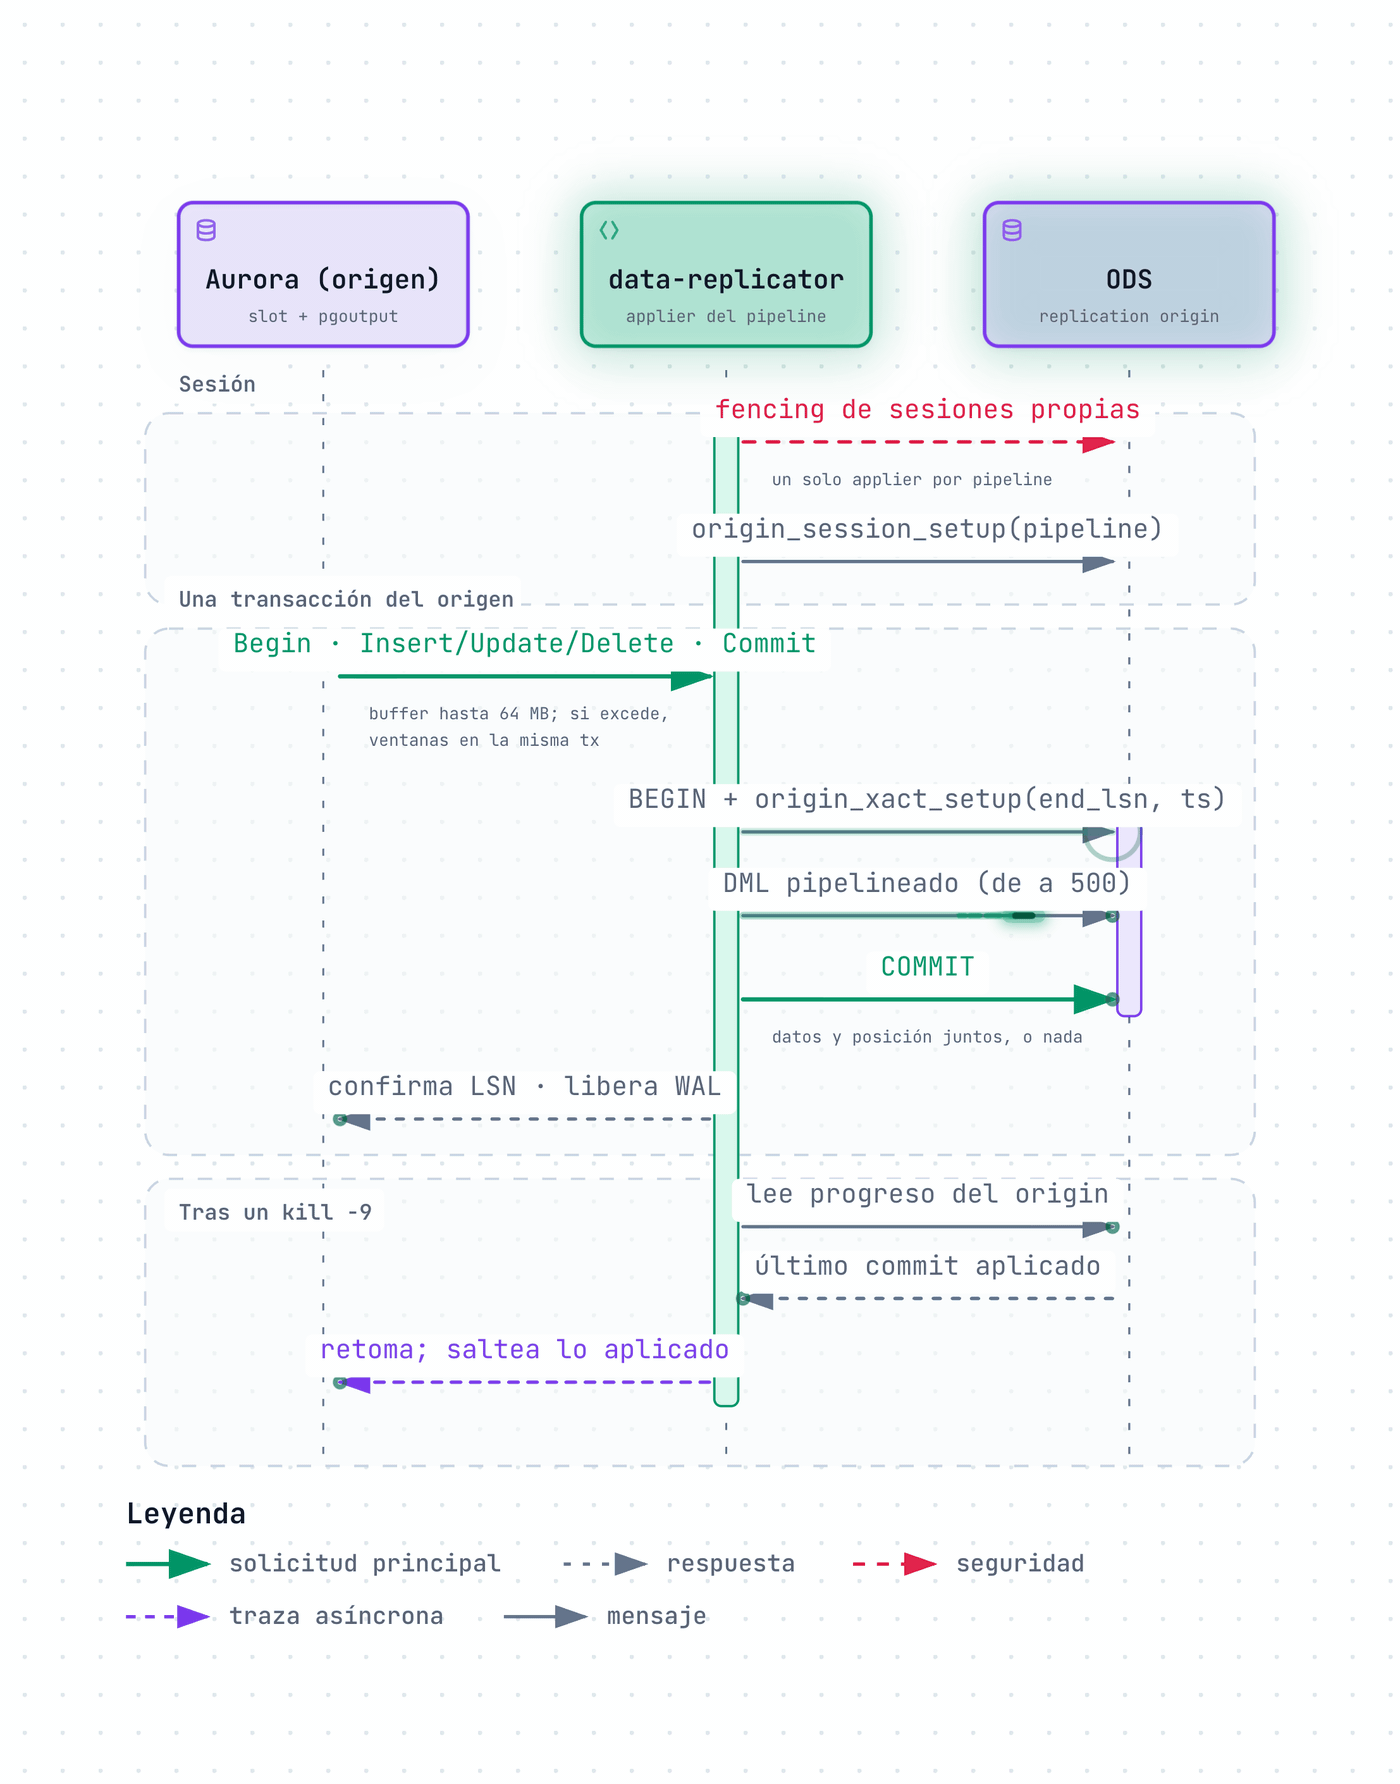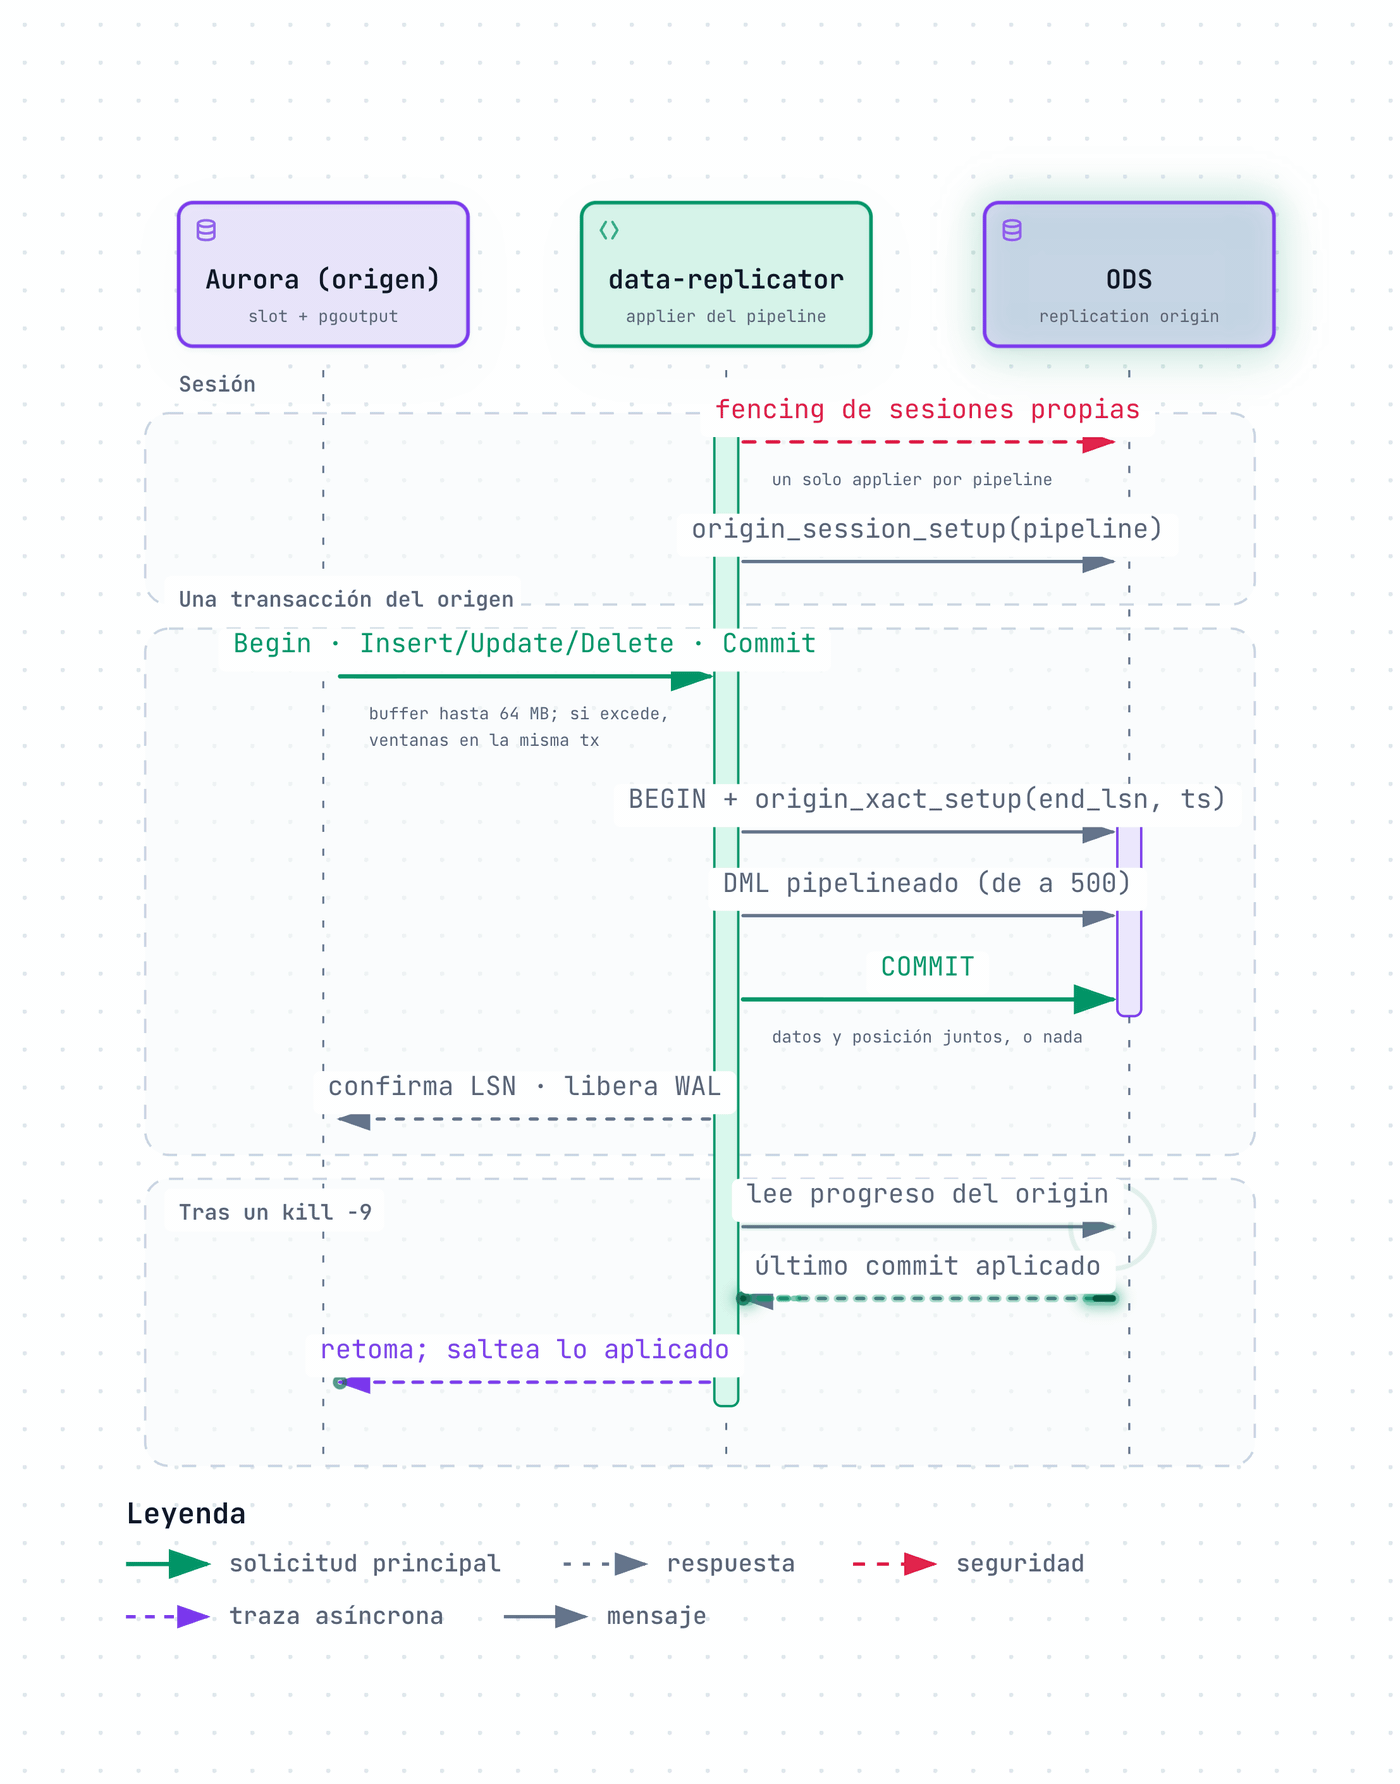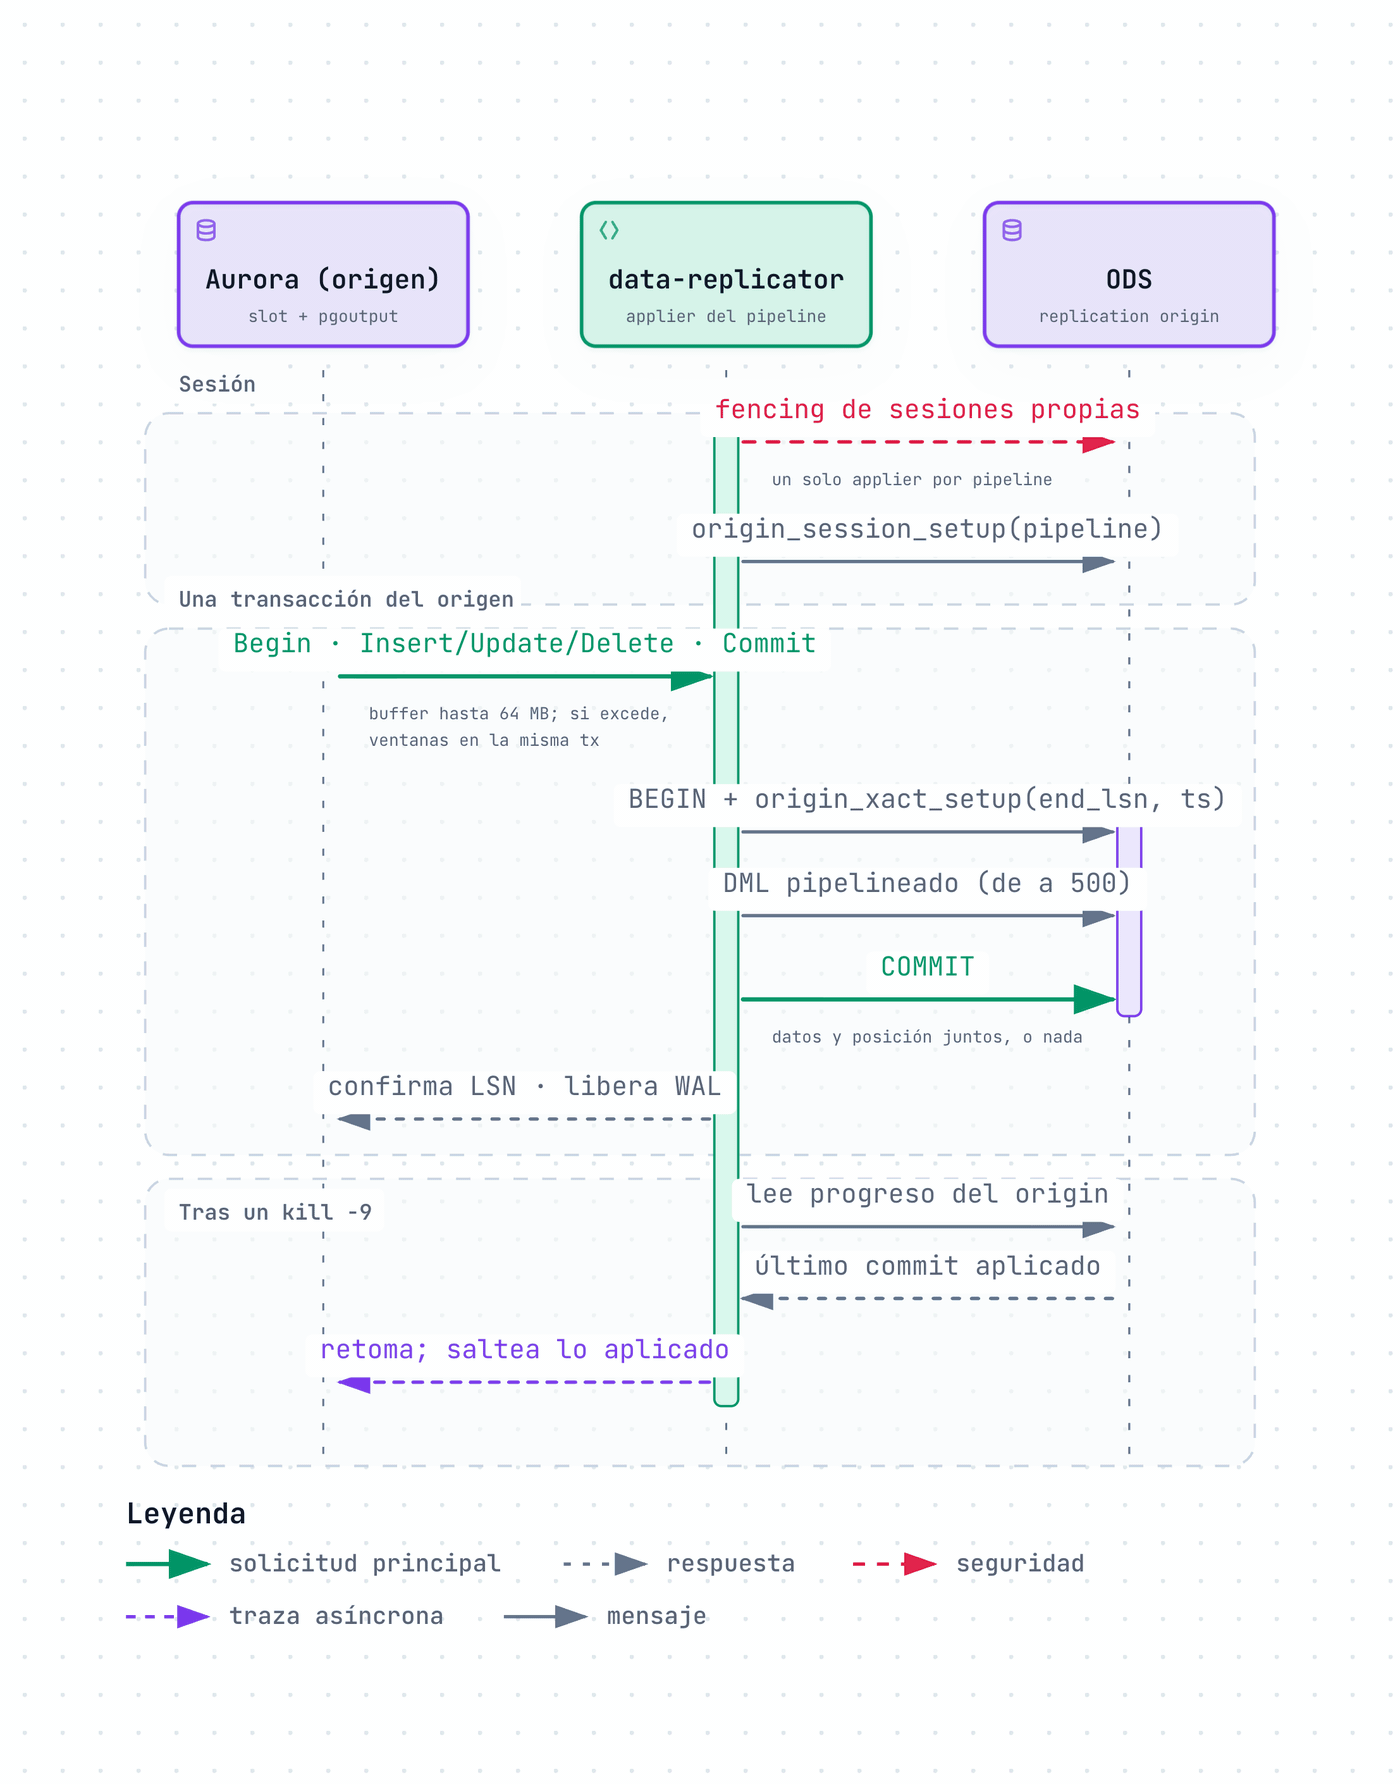
Acá está el corazón del asunto y lo que nos hace sacar pecho. ¿Se acuerdan del checkpoint que DMS guarda por separado? Nosotros hacemos que los datos y la posición se commiteen juntos, en la misma transacción del ODS, usando los replication origins de PostgreSQL:
-- simplificado: una vez por sesión, el applier se ata al origin de su pipeline
SELECT pg_replication_origin_session_setup('<origin de un pipeline>');

-- por cada transacción que llega del origen
BEGIN;
SELECT pg_replication_origin_xact_setup('<end_lsn>', '<commit_ts>');
INSERT ...; UPDATE ...; DELETE ...;
COMMIT; -- datos y "hasta dónde llegué", juntos o nada
¿Qué significa esto en la práctica? Que si le metés un kill -9 al pod a mitad de una transacción, o se aplicó todo o no se aplicó nada; y al volver retoma exactamente desde el último commit, salteando lo que ya estaba aplicado. Lo validamos rompiendo cosas a propósito en dev, rewinds del slot y failovers de Aurora incluidos.
Paso a paso, con el kill -9 incluido:
Nada es gratis, claro, y esto trae su letra chica:
- Un replication origin por pipeline en el ODS, lo que nos obligó a subir
max_replication_slotsde 20 (el default) a 100. Es un parámetro estático, osea reboot del writer; DMS no lo necesitaba justamente porque guarda su checkpoint aparte. - Un solo applier por pipeline, siempre. El Deployment corre con
strategy: Recreate–nada de rolling update con dos pods escribiendo a la vez– y al arrancar hace fencing de cualquier sesión propia que haya quedado viva. KEDA y HPA están prohibidos en este Deployment, y no es chiste.
Fallar en voz alta y en chiquito
Si DMS fallaba en silencio y a lo grande, acá la idea fue la inversa: fallar en voz alta y lo más acotado posible. Algunos casos:
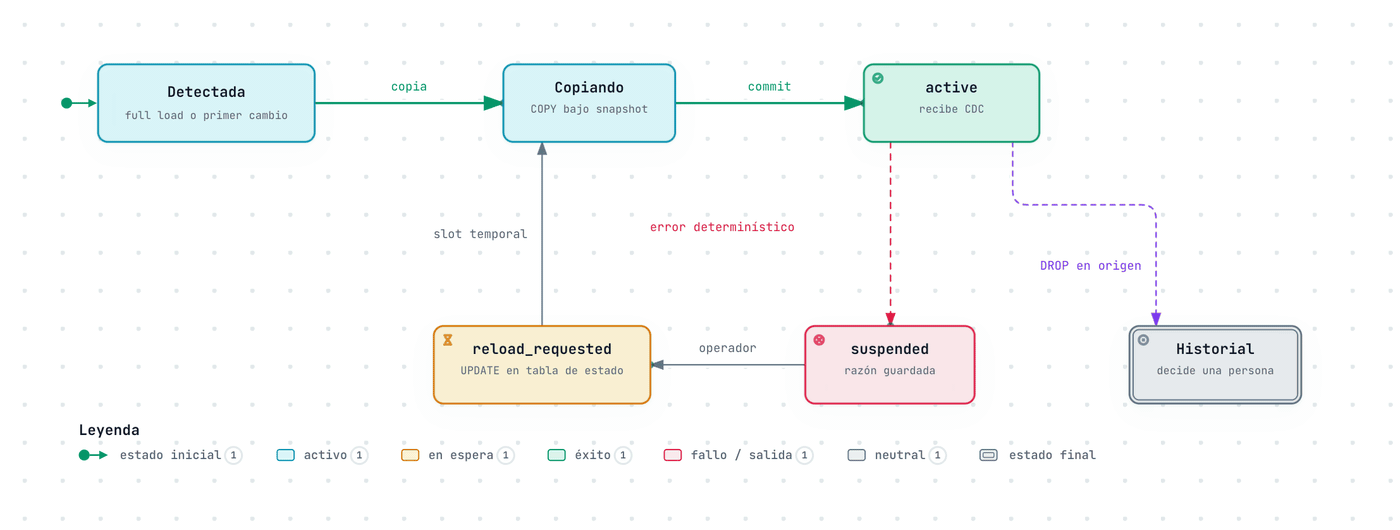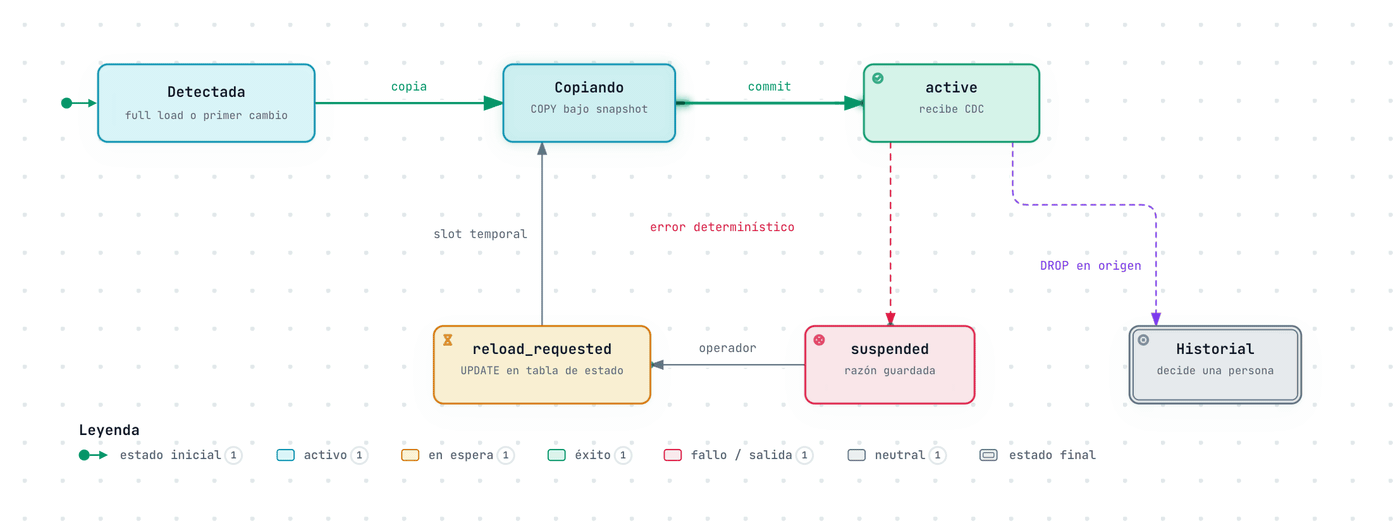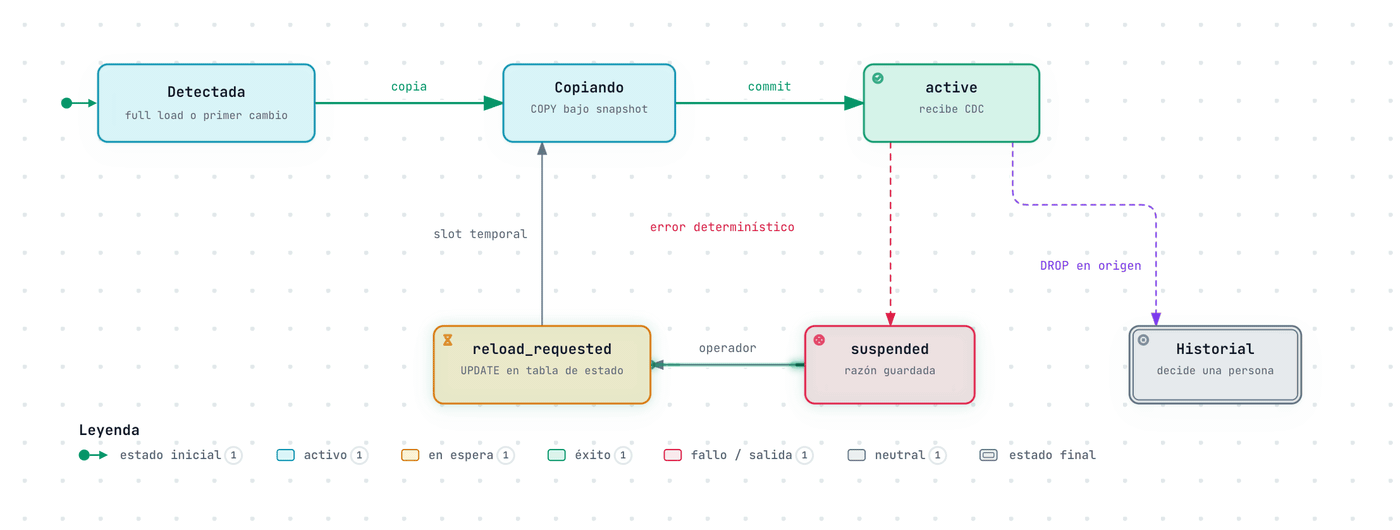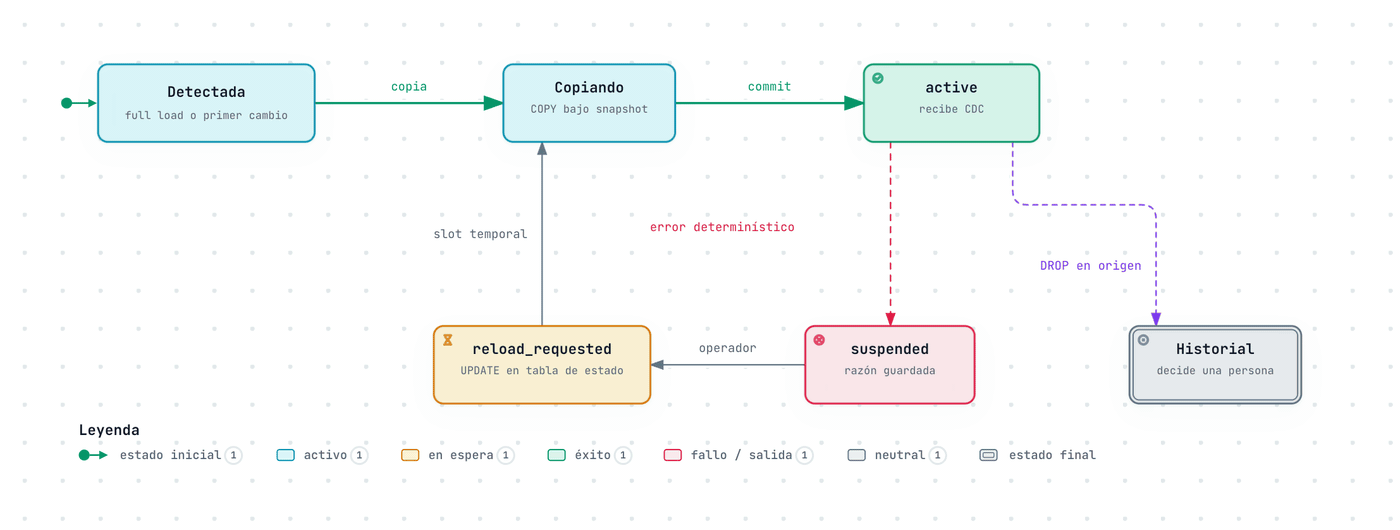
- Error determinístico en una tabla (un tipo que no encaja, una constraint, una columna que falta), se suspende solo esa tabla, se guarda la razón y salta una alerta P1; el resto del pipeline sigue como si nada.
- El origen agrega una columna, se replica el
ADD COLUMNautomáticamente, y desde el data-replicator con el valor que la fuente materializó para las filas viejas, así unDEFAULT 'x'deja las filas previas iguales de los dos lados. Si el default es volátil (clock_timestamp(),nextval()) esas filas quedan en NULL en el destino y el replicador avisa. - Tabla nueva en el origen, se detecta en su primer cambio y se copia sola.
- El origen dropea una tabla, no se propaga (DMS sí lo hacía). La copia queda como historial y decide una persona; borrar datos no es algo que queramos que pase solo.
- Una tabla destino con otro dueño, si otro escritor creó una tabla con nuestro nombre –nos pasó con un DMS que un deploy volvió a levantar– se suspende esa tabla y jamás se escribe encima.
- Transacciones gigantes, se bufferean hasta 64 MB y si son más grandes se aplican por ventanas dentro de la misma transacción del ODS: la memoria la acota la ventana, no la transacción. Confieso que hasta la v0.2.11 del data-replicator eso era un tope y la transacción que lo superaba dejaba el pipeline en loop; de los errores se aprende.
- Corte de red u ODS reiniciado, reconexión con backoff y replay desde el origin. Exactly-once mediante, no hay nada que limpiar.
Y para recuperar una tabla suspendida? un UPDATE en la tabla de estado del replicador pasándola a reload_requested, y se encarga solo de hacer una copia fresca por un slot temporal.
Visto desde una tabla, el ciclo queda así:
Que el silencio también avise
Todas las métricas salen por OpenTelemetry a Coralogix con el pipeline como label: estado de cada tabla, lag en segundos y en bytes de WAL retenido, eventos descartados, reconexiones y transacciones aplicadas. Sobre eso montamos tres niveles de alertas:
- P1, tabla suspendida.
- P2, lag alto, pipeline silencioso o eventos descartados.
- P3, reconexiones sostenidas o WAL retenido.
Fíjense en “pipeline silencioso”, es la alerta que nos hubiese ahorrado esos meses de DMS en failed.
Ahora, qué pasa si el que se muere es el pod? un pod muerto no puede avisar que está muerto 😅. Para eso tenemos un backstop desde el origen, una alarma de CloudWatch por cluster que salta si el slot retiene más de 10 GiB durante una hora; esa alarma sobrevive al pod.
Y para el día a día, una query que nos dice en un vistazo cómo está un tenant:
-- salud de un tenant, en el ODS: no_activas tiene que ser 0
SELECT p.pipeline, p.target_schema,
       count(t.table_name) FILTER (WHERE t.state = 'active')  AS activas,
       count(t.table_name) FILTER (WHERE t.state <> 'active') AS no_activas
FROM _replicator.pipeline_state p
LEFT JOIN _replicator.table_state t USING (pipeline)
GROUP BY 1, 2 ORDER BY 1;
Un toggle en Port y el resto se autodescubre
Si leyeron la publicación anterior saben que Port es nuestra capa de presentación, así que acá no podía ser distinto. Cada proyecto tiene una entidad replication en Port con lo mínimo: si está habilitada, a qué schema escribe y alguna que otra opción, con overrides por tenant y entorno para las diferencias.
A partir de ahí:
- El deploy del proyecto, si la entidad está habilitada y el replicador existe en el tenant, crea el publisher: el usuario, la publication, la regla de security group desde el pod y un secret con la conexión. El gate de PK que les comenté más arriba vive acá.
- El deploy del data-replicator, descubre esos secrets por tag, los cruza con las entidades de Port y arma la configuración de los pipelines. Entidad habilitada sin publisher, o publisher sin entidad, es un warning y sigue.
- El core-stack del tenant, crea el usuario del lado del ODS y deja
max_replication_slotsen 100.
“Todo debe autodescubrirse, no ‘harcodiemos’ nada”, ¿les suena? 😉
Pausar un pipeline es poner enabled: false. Eso sí, atenti: borrar la entidad borra el publisher y deja el slot sin consumidor, y ya saben lo que pasa con un slot sin consumidor (sí, la alarma de arriba).
Una regla que nos ahorró más de un dolor de cabeza: el deploy del proyecto va después de habilitar la entidad, y se verifica que salió bien mirando que exista el secret del publisher, no porque el pipeline dijo “terminó”.
Shadow y corte: cambiar el motor con el auto andando
No queríamos un big bang. En los tenants donde DMS seguía vivo, cada pipeline escribe en un schema paralelo, shadow_<proyecto>, con los mismos nombres de tabla que DMS deja en public. Así conviven sin pisarse, comparamos paridad con tráfico real y los consumidores pueden construir sus índices sobre el shadow con calma.
De punta a punta, el recorrido es este:
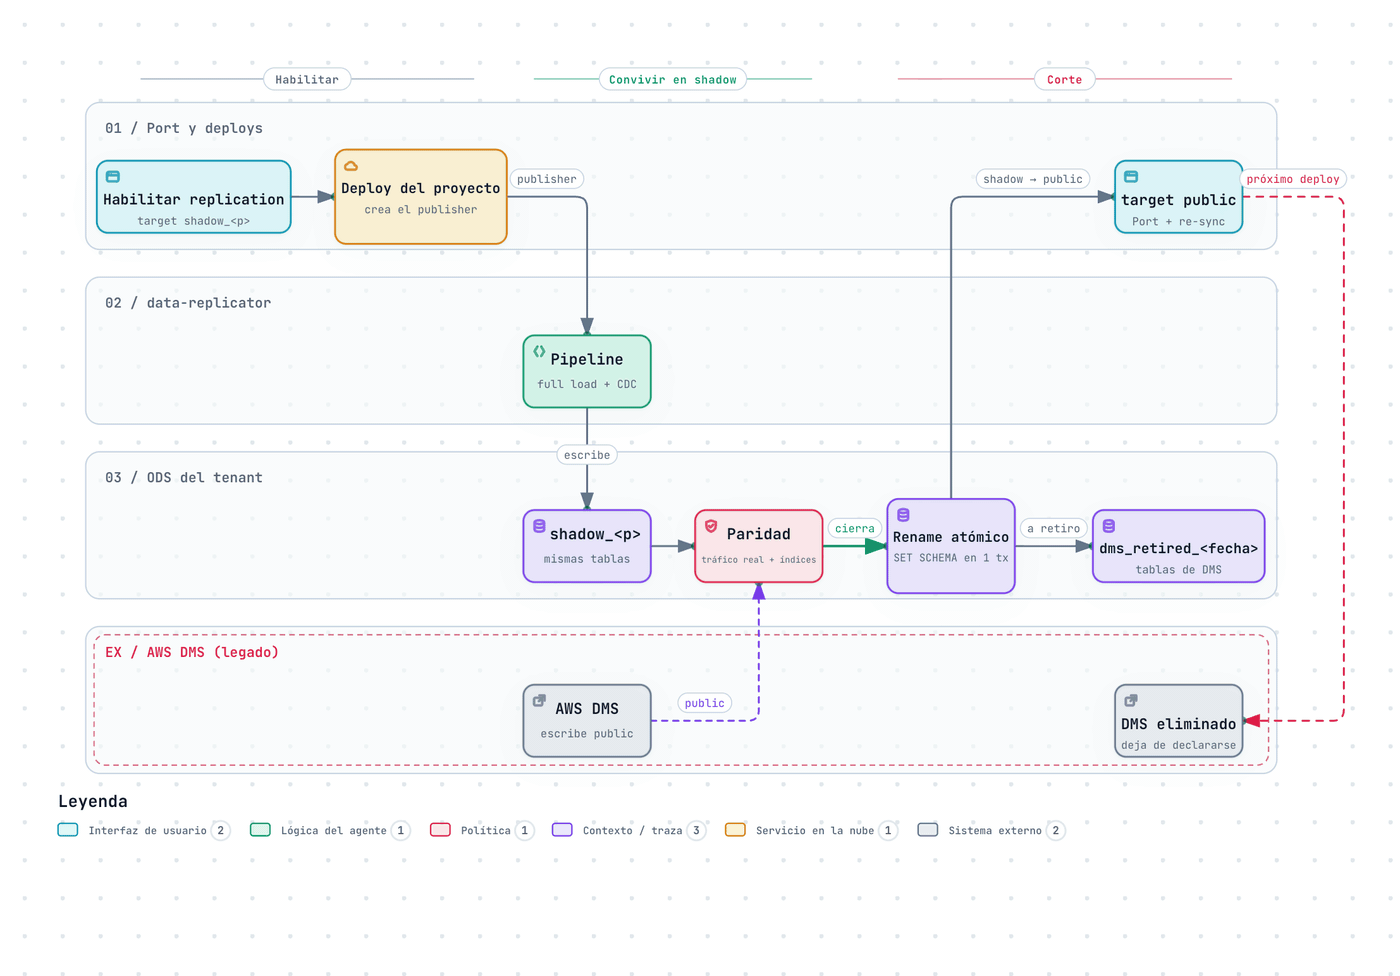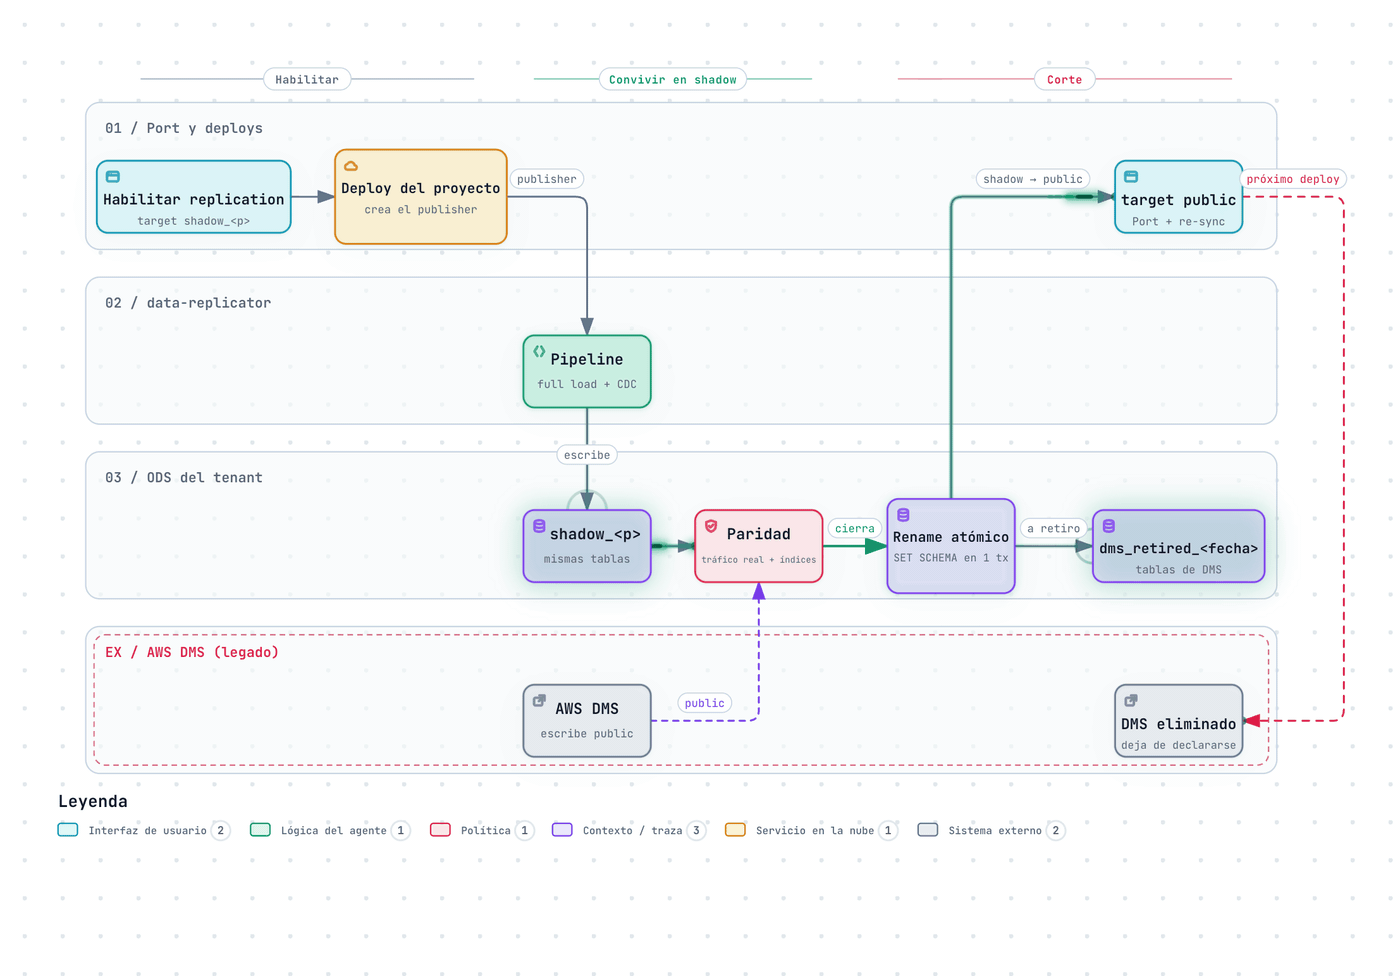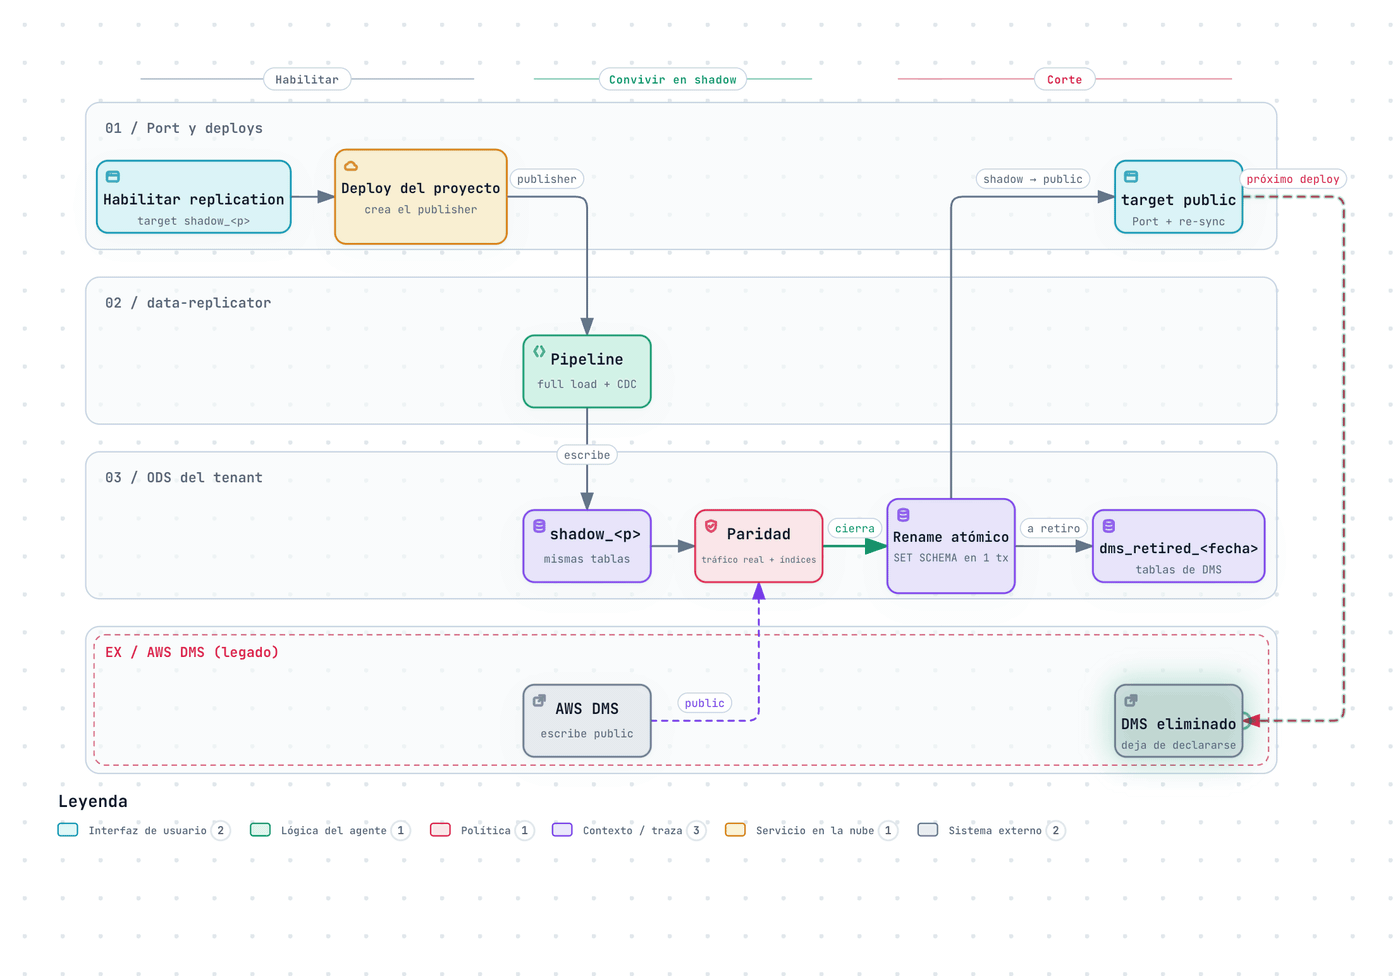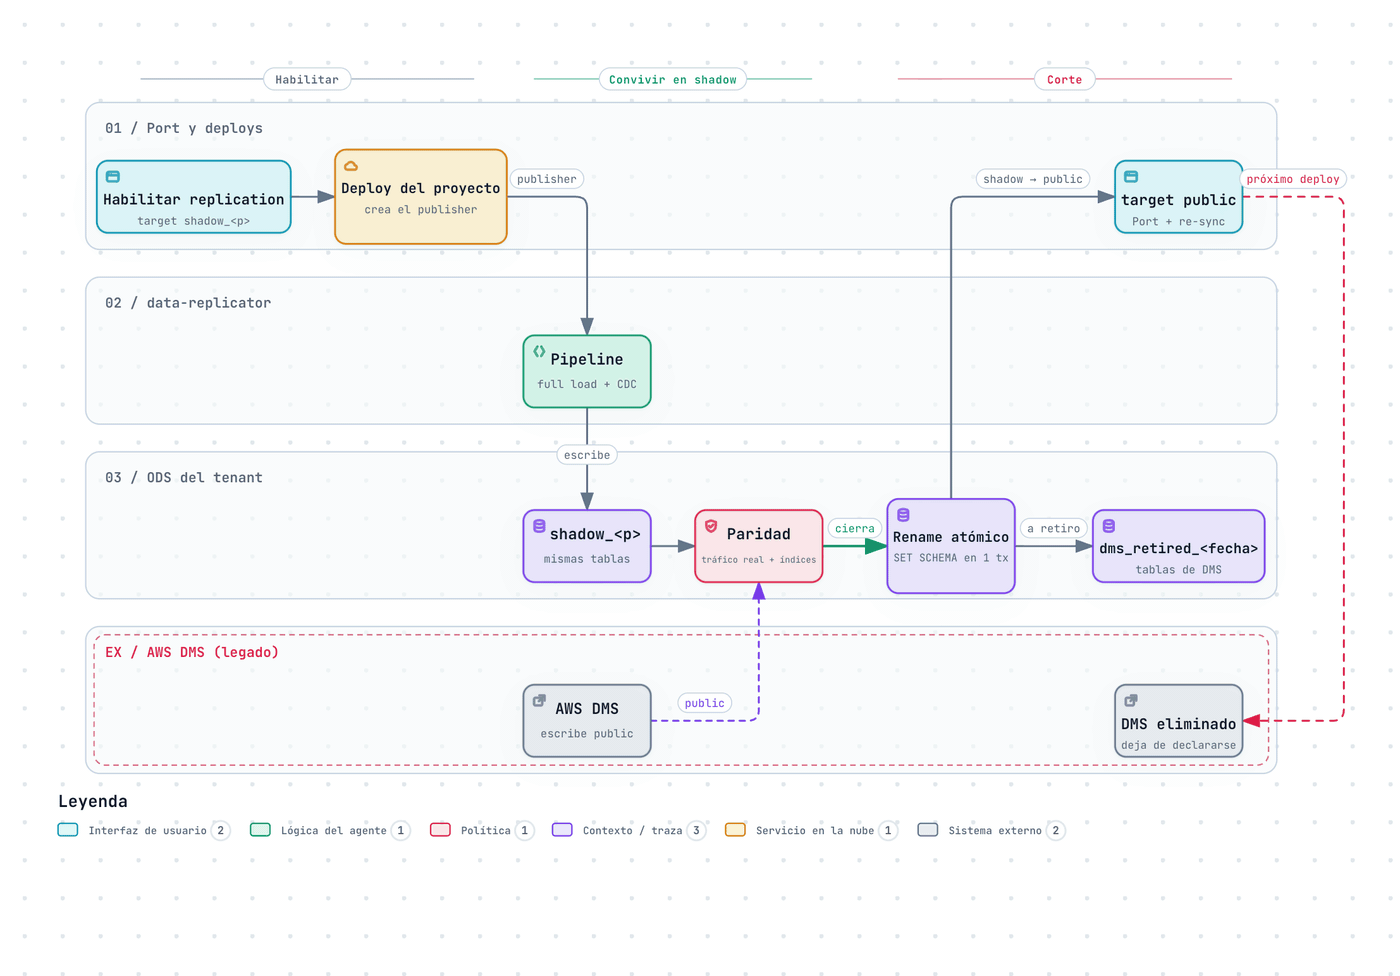
Cuando todo cierra, el corte es un rename atómico en una sola transacción:
-- simplificado; el de verdad vive en nuestro runbook
BEGIN;
CREATE SCHEMA dms_retired_<fecha>;
ALTER TABLE public.<tabla>     SET SCHEMA dms_retired_<fecha>;  -- lo de DMS, a retiro
ALTER TABLE shadow_<p>.<tabla> SET SCHEMA public;               -- lo nuestro, a producción
-- ...por cada tabla, y se actualiza el target_schema del pipeline
COMMIT;
SET SCHEMA arrastra índices, constraints y permisos, así que no hay full load, la ventana es de segundos y el rollback es simétrico (el mismo movimiento al revés). Después se cambia el schema destino en Port, se re-sincroniza y el siguiente deploy del proyecto borra su DMS solo: si la entidad replication está habilitada en public, el dueño es el replicador y DMS deja de declararse.
Al momento de escribir esto (números finalizando octubre) tenemos 23 pipelines corriendo en dev, 114 en producción ya cortadas definitivamente a public.
El mañana es un misterio
Como dice el maestro Oogway, el mañana es un misterio, pero algunas cosas ya las tenemos en el radar:
- Terminar los cortes, y que se apague el último DMS; ese día va a haber festejo.
- Hot reload de la configuración, hoy cambiar la config reinicia el pod; es un reinicio limpio porque todas los pipelines retoman desde su origin, pero queremos montar la config como ConfigMap y recargarla en caliente.
Conclusiones
Para ir cerrando quiero dejar algunas reglas que nos quedaron tatuadas en este camino:
- La fuente de verdad del ODS es el ODS, no las estadísticas de DMS ni lo que diga una consola.
- Todo conteo de una API de AWS que vuelve exactamente 100 es paginación. Parece un chiste, pero no lo es 😅.
- Fallar está bien, fallar en silencio no. Mil veces prefiero una tabla suspendida con su razón y una alerta P1 que un “running” que no corre.
- Shadow antes que big bang, convivir, comparar y recién después cortar y cambiar.
Reemplazar un servicio administrado de AWS por algo propio da vértigo, y está bien que lo dé; pero cuando lo que pagás no te da garantías y encima no te avisa cuando se rompe, construir con garantías claras –exactly-once, fallas acotadas y visibles, un core que se puede revertir– es lo más parecido a hacer las cosas bien y dormir tranquilos.
Esto fue el primer capítulo de la trilogía, en las próximas publicaciones Cris y Jere van a contar lo suyo así que estén atentos.
Hasta la próxima 👋🏽